---
title: "Incident Response: dalla detection all’azione, come reagire in tempo"
description: Processi, ruoli e piani per gestire gli incidenti di cyber security e proteggere continuità operativa e resilienza del business.
image: https://blog.quanture.com/hubfs/124.png
---
[](https://quanture.com)
- [WE ARE](https://www.quanture.com/we-are/)
- [WE CARE](https://www.quanture.com/we-care/)
- [JOIN US](https://www.quanture.com/join-us/)
- [SUCCESS STORIES](https://www.quanture.com/case-studies/)
- [DOT](https://blog.quanture.com/)
- [MY.QUANTURE](https://www.quanture.com/myquanture/)
- IT Design & Engineering
### [IT Design & Engineering](https://www.quanture.com/it-infrastructure/)
Massimizza l’efficienza e la sicurezza del tuo ecosistema IT.
[Scopri di più](https://www.quanture.com/it-infrastructure/)
[Scopri i nostri IT services](https://www.quanture.com/it-services/)
[Hybrid Infrastructure](https://www.quanture.com/it-infrastructure/hybrid-infrastructure/) - [Infrastructure as a Service](https://www.quanture.com/managed-service/infrastructure-as-a-service/)
- [On Premise | Server & Storage, Iperconvergenza, Virtualizzazione](https://www.quanture.com/it-solutions/on-premises-virtualizzazione-iperconvergenza-server-storage/)
- [Azure Public Cloud](https://www.quanture.com/it-solutions/public-cloud-ms-azure/)
- [ArQive | Storage your data](https://www.quanture.com/managed-service/object-storage-s3/)
- [Infrastructure Assesment](https://www.quanture.com/it-consultancy-services/infrastructure-assesment/)
- [Cloud Readiness Assessment](https://www.quanture.com/it-consultancy-services/cloud-readiness-assessment/)
[Networking](https://www.quanture.com/it-infrastructure/networking/) - [Data Center Networking](https://www.quanture.com/it-solutions/data-center-networking/)
- [Wired e Wireless](https://www.quanture.com/it-solutions/reti-lan-wlan/)
- [WAN e SD-WAN](https://www.quanture.com/it-solutions/sd-wan/)
- [Network Security](https://www.quanture.com/it-solutions/network-security/)
- [Network Assessment](https://www.quanture.com/it-consultancy-services/network-assessment/)
- [Wi-fi Site Survey](https://www.quanture.com/it-consultancy-services/wifi-site-survey/)
[Business Continuity](https://www.quanture.com/it-infrastructure/business-continuity/) - [Data Resiliency](https://www.quanture.com/it-solutions/data-resiliency/)
- [Business Continuity](https://www.quanture.com/it-solutions/business-continuity/)
- [Zero Time – RPO & RTO Assessment](https://www.quanture.com/it-consultancy-services/disaster-recovery-assessment/)
[Monitoraggio delle risorse](https://www.quanture.com/managed-service/it-monitoring/) [Business & Technical Consultancy](https://www.quanture.com/it-consultancy-services/) [Support Services](https://www.quanture.com/support-services/) [Presidio as a Service](https://www.quanture.com/managed-service/presidio-informatico/)
[Scopri di più](https://www.quanture.com/it-infrastructure/)
[Scopri i nostri IT services](https://www.quanture.com/it-services/)
- Smart Productivity
### [Smart Productivity](https://www.quanture.com/smart-productivity/)
Sfrutta appieno le tue risorse, ottimizza i flussi di lavoro e incrementa la produttività.
[Scopri di più](https://www.quanture.com/smart-productivity/)
[Scopri i nostri IT services](https://www.quanture.com/it-services/)
[Collaboration and Communication](https://www.quanture.com/smart-productivity/collaboration-and-communication/) - [Productivity Suite](https://www.quanture.com/it-solutions/productivity-suite/)
- [Enterprise Collaboration](https://www.quanture.com/it-solutions/enterprise-collaboration/)
- [Enterprise Voice](https://www.quanture.com/it-solutions/enterprise-voice/)
- [Data Governance& AI:Copilot Suite](https://www.quanture.com/it-solutions/copilot-ai/)
[Workplace](https://www.quanture.com/smart-productivity/postazioni-lavoro/) - [Mobile Device Management](https://www.quanture.com/it-solutions/mobile-device-management/)
- [Virtual Workplace](https://www.quanture.com/it-solutions/virtual-workplace/)
- [Workplace as a Service](https://www.quanture.com/managed-service/workplace-as-a-service/)
- [E-mail Security](https://www.quanture.com/it-solutions/email-security/)
- [End-Point Security](https://www.quanture.com/it-solutions/endpoint-security/)
[Printing Solutions](https://www.quanture.com/smart-productivity/printing-solutions/) - [Printing Managed Services](https://www.quanture.com/managed-service/managed-print-services/)
[Monitoraggio delle risorse](https://www.quanture.com/managed-service/it-monitoring/) [Business & Technical Consultancy](https://www.quanture.com/it-consultancy-services/) [Support Services](https://www.quanture.com/support-services/) [Presidio as a Service](https://www.quanture.com/managed-service/presidio-informatico/)
[Scopri di più](https://www.quanture.com/smart-productivity/)
[Scopri i nostri IT services](https://www.quanture.com/it-services/)
- Cyber Security
### [Cyber Security](https://www.quanture.com/cyber-security/)
Proteggi i tuoi asset digitali e garantisci la sicurezza dei dati e la continuità operativa della tua azienda.
[Scopri di più](https://www.quanture.com/cyber-security/)
[Scopri i nostri IT services](https://www.quanture.com/it-services/)
[Security Platform](https://quanture.com/cyber-security/security-platform/) - [Network Security](https://www.quanture.com/it-solutions/network-security/)
- [End-Point Security](https://www.quanture.com/it-solutions/endpoint-security/)
- [E-mail Security](https://www.quanture.com/it-solutions/email-security/)
- [Data Resiliency](https://www.quanture.com/it-solutions/data-resiliency/)
- [Digital Identity & Access Security](https://www.quanture.com/it-solutions/iam-security/)
- [Cyber Security Awareness](https://www.quanture.com/it-consultancy-services/cyber-security-awareness/)
- [Active Directory Security Assessment](https://www.quanture.com/it-consultancy-services/active-directory-security-assessment/)
- [M365 Security Hardening](https://www.quanture.com/it-consultancy-services/m365-security-hardening/)
- [Zero Time – RPO & RTO Assessment](https://www.quanture.com/it-consultancy-services/disaster-recovery-assessment/)
[Ethical Hacking](https://www.quanture.com/cyber-security/ethical-hacking/) - [Vulnerability Assessment](https://www.quanture.com/it-consultancy-services/vulnerability-assessment/)
- [Penetration Test](https://www.quanture.com/it-consultancy-services/penetration-test/)
- [Web Application Penetration Test](https://www.quanture.com/it-consultancy-services/wapt/)
- [Mobile Application Penetration Test](https://www.quanture.com/it-consultancy-services/mobile-application-penetration-test/)
- [Wireless Penetration Test](https://www.quanture.com/it-consultancy-services/wireless-penetration-test/)
- [Phising Attack Test](https://www.quanture.com/it-consultancy-services/phishing-attack-test/)
[Cyber Security Managed Services](https://quanture.com/cyber-security/managed-services/) - [Vulnerability Monitoring](https://www.quanture.com/managed-service/vulnerability-monitoring/)
- [Vulnerability Management](https://www.quanture.com/managed-service/vulnerability-management/)
- [Intacto – Backup e Disaster Recovery as a Service](https://www.quanture.com/managed-service/disaster-recovery-as-a-service/)
- [EPQ – Endpoint Protection Quanture](https://www.quanture.com/managed-service/endpoint-protection/)
- [E-mail Security Complete](https://www.quanture.com/managed-service/vulnerability-monitoring/)
[Monitoraggio delle risorse](https://www.quanture.com/managed-service/it-monitoring/) [Business & Technical Consultancy](https://www.quanture.com/it-consultancy-services/) [Support Services](https://www.quanture.com/support-services/) [Presidio as a Service](https://www.quanture.com/managed-service/presidio-informatico/)
[Scopri di più](https://www.quanture.com/cyber-security/)
[Scopri i nostri IT services](https://www.quanture.com/it-services/)
- [Microsoft Advisory Services](https://www.quanture.com/microsoft-advisory-services/)
### [Microsoft Advisory Services](https://www.quanture.com/microsoft-advisory-services/)
Tutto il potenziale del Cloud e della suite M365 al servizio del tuo business.
[Scopri di più](https://www.quanture.com/microsoft-advisory-services/)
[Scopri i nostri IT services](https://www.quanture.com/it-services/)
[Active Directory & Domain Services](https://www.quanture.com/microsoft-advisory-services/active-directory-domain-services/) - [Microsoft Active Directory](https://www.quanture.com/it-solutions/microsoft-active-directory/)
- [Microsoft ENTRA](https://www.quanture.com/it-solutions/microsoft-entra/)
- [Active Directory Security Assessment](https://www.quanture.com/it-consultancy-services/active-directory-security-assessment/)
- [Integrazione e separazione di foreste e domini](https://www.quanture.com/it-solutions/active-directory-integration/)
[Remotizzazione delle postazioni o delle applicazioni](https://quanture.com/microsoft-advisory-services/remotizzazione-desktop/) - Azure Virtual Desktop
[Microsoft Cloud: Infrastructure & Productivity](https://www.quanture.com/microsoft-advisory-services/microsoft-cloud-infrastructure-productivity/) - [Azure Public Cloud](https://www.quanture.com/it-solutions/public-cloud-ms-azure/)
- [Collaboration and Communication](https://www.quanture.com/smart-productivity/collaboration-and-communication/)
- [Data Governance & AI: Copilot Suite](https://www.quanture.com/it-solutions/copilot-ai/)
[SQL Server](https://www.quanture.com/microsoft-advisory-services/server-sql/)
[Microsoft Dev Platform](https://www.quanture.com/development/)
[Business & Technical Consultancy](https://www.quanture.com/it-consultancy-services/) [Support Services](https://www.quanture.com/support-services/) [Presidio as a Service](https://www.quanture.com/managed-service/presidio-informatico/)
[Scopri di più](https://www.quanture.com/microsoft-advisory-services/)
[Scopri i nostri IT services](https://www.quanture.com/it-services/)
- [Dev & Apps](https://www.quanture.com/development/)
# Incident Response: dalla detection all’azione, come reagire in tempo
20/01/2026
Tag:
[Cyber Security](https://blog.quanture.com/tag/cyber-security)
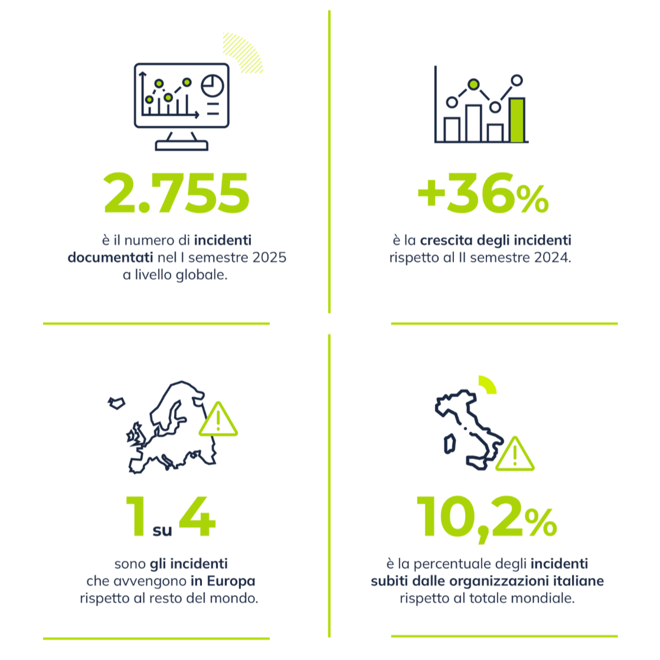
Il quadro delineato dal Rapporto Clusit sulla Cybersecurity in Italia evidenzia come gli **incidenti di sicurezza informatica** rappresentino ormai **una condizione strutturale di rischio per organizzazioni pubbliche e private**. La crescita costante del numero di incidenti gravi, unita all’aumento della loro complessità e dell’impatto operativo, sta mettendo sotto pressione la continuità dei servizi e la capacità di risposta delle aziende.
In particolare, il report sottolinea come una quota rilevante degli incidenti abbia effetti diretti sulla **disponibilità dei sistemi**, sull’**integrità dei dati** e sull’**operatività delle filiere digitali**, ampliando l’impatto ben oltre il perimetro tecnologico.
#### Incidenti cyber, i numeri chiave
[](https://blog.quanture.com/hubfs/Rich%20Media/Incident%20response/Incident%20Response_dalla%20detection%20all%E2%80%99azione%2c%20come%20reagire%20in%20tempo_Grafico%201b.png)
Fonte: [Rapporto Clusit](https://clusit.it/rapporto-clusit/) – Aggiornamento ottobre 2025.
## Perché oggi l’Incident Response è una priorità di business
Alla luce di una crescita così marcata degli incidenti, risulta evidente come la capacità di **rilevare tempestivamente gli eventi, contenerne gli effetti e ripristinare i servizi critici** si colloca al crocevia tra **gestione del rischio, continuità del business e responsabilità diretta del top management**, diventando una leva strategica per la tutela del valore aziendale.
L’entrata in vigore della **direttiva** [**NIS2**](https://blog.quanture.com/cose-la-direttiva-nis2-e-quali-obblighi-di-cybersecurity-richiede) e del **regolamento DORA**, insieme agli obblighi di notifica e accountability previsti dal **GDPR**, infatti, ha spostato in modo esplicito la responsabilità della gestione del rischio cyber sui vertici aziendali. L’Incident Response rientra a pieno titolo nelle responsabilità di governance, con effetti diretti sulle decisioni strategiche e potenziali conseguenze per l’organizzazione e i suoi organi di amministrazione in caso di processi inadeguati, sia sul piano sanzionatorio sia su quello reputazionale.
I report di settore e le indicazioni normative convergono quindi su un punto chiave: la domanda non è più se un’organizzazione subirà un incidente di sicurezza, ma quanto rapidamente e con quale coordinamento sarà in grado di gestirlo. È quindi anche su questa capacità che si misura oggi la resilienza digitale e, di conseguenza, la solidità del business nel medio-lungo periodo.
## Che cos’è l’Incident Response e quali obiettivi si pone
Secondo il NIST (National Institute of Standards and Technology), uno dei riferimenti più autorevoli in materia, l’Incident Response è l’insieme coordinato di **processi, ruoli e strumenti** attraverso cui un’organizzazione **si prepara, rileva, analizza, contiene e assorbe gli effetti di un incidente di cyber security**, integrando queste attività nel più ampio ciclo di gestione del rischio.
Il modello di riferimento distingue tra due livelli strettamente connessi.
- Da un lato le **funzioni di Govern, Identify e Protect**, che costituiscono lo strato di preparazione e governo del rischio.
- Dall’altro le **funzioni di Detect, Respond e Recover**, che rappresentano il cuore operativo della Incident Response.
A collegare questi livelli è **un processo di** **miglioramento continuo**, alimentato dall’analisi sistematica degli incidenti e delle lessons learned.
Gli obiettivi di una capability di Incident Response efficace sono molteplici, ma riconducibili ad alcune finalità chiave. Innanzitutto, **ridurre l’impatto tecnico e di business** degli incidenti, limitando indisponibilità dei servizi, compromissioni dei dati e interruzioni operative. In secondo luogo, **ripristinare rapidamente i servizi critici**, rispettando gli obiettivi di recupero definiti nei piani di continuità. Un terzo obiettivo è **contenere la propagazione dell’incidente**, evitando che si estenda ad altri sistemi, sedi o attori della supply chain. Infine, ogni incidente deve diventare **un’occasione di apprendimento**, utile a **rafforzare controlli, processi e competenze interne**.
L’Incident Response non sostituisce altre funzioni di sicurezza, come ad esempio il [vulnerability management](https://blog.quanture.com/identity-and-access-management-funzionalit%C3%A0-chiave-e-vantaggi), ma le integra: un incidente causato da una vulnerabilità non gestita deve tradursi in un miglioramento strutturale delle pratiche di gestione e di configurazione dei sistemi. In questa prospettiva, l’Incident Response non è un insieme di reazioni isolate, ma **un** **processo strutturato e continuo**.
## Incident response team: ruoli, responsabilità e competenze chiave
Dato il perimetro di attività così articolato, l’Incident Response non può essere affidato a singoli specialisti isolati o a interventi occasionali. Serve **un** **team strutturato, con ruoli definiti, responsabilità chiare e collaborazione costante con le altre funzioni di sicurezza e IT**. Ciò che conta è la capacità del team di **orchestrare competenze eterogenee**. Una possibile articolazione dei ruoli chiave è la seguente.
#### CSIRT - Computer Security Incident Response
| **Ruolo** | **Responsabilità principali** | **Competenze distintive** |
| --- | --- | --- |
| **Incident commander** | Coordina la risposta, gestisce le priorità, decide sulle azioni critiche di contenimento e recovery, interfaccia il management. | Leadership, capacità decisionale in contesti incompleti, gestione della crisi, visione risk‑based. |
| **Lead analyst / triage** | Valuta gli alert, classifica gli eventi, attiva i playbook, coordina gli analisti tecnici. | SIEM, EDR, log analysis, conoscenza di MITRE ATT&CK e dei pattern di attacco più diffusi. |
| **Forensics specialist** | Conduce analisi forense su host, rete e supporti, ricostruisce la catena di attacco, raccoglie evidenze. | Digital forensics, memory e disk analysis, metodologie di catena di custodia, familiarità con strumenti DFIR. |
| **Threat intelligence analyst** | Arricchisce i casi con informazioni su attori, TTP, indicatori di compromissione, contesto geopolitico e settoriale. | Cyber threat intelligence, uso avanzato di MITRE ATT&CK, capacità di sintesi e reporting per stakeholder diversi. |
| **SOC / monitoring analyst** | Gestisce il monitoraggio continuo, affina le regole di rilevazione, filtra falsi positivi, alimenta IR con eventi qualificati. | SIEM, SOAR, tuning di use case di detection, conoscenza delle architetture di log in ambienti cloud e ibridi. |
| **IT / cloud engineer** | Implementa le azioni tecniche di isolamento, patching, restore, re‑configurazione di sistemi e servizi. | Amministrazione di sistemi on‑premise, competenze su Azure e altri cloud, networking, automazione infrastrutturale. |
| **Referente OT / produzione** | Valuta l’impatto sugli impianti produttivi, coordina le azioni in campo, bilancia sicurezza e continuità operativa. | Conoscenza dei sistemi di controllo industriale, processi di stabilimento, requisiti di safety e disponibilità. |
| **Legal & compliance** | Supporta notifiche alle autorità, gestione di data breach, aspetti contrattuali e di responsabilità. | Normative come GDPR, NIS2 e DORA, gestione di data breach, linguaggio legale applicato agli incidenti cyber. |
| **Comunicazione / PR** | Gestisce comunicazione interna ed esterna in caso di incidenti gravi, presidia i messaggi verso clienti e media. | Comunicazione di crisi, capacità di tradurre aspetti tecnici in messaggi chiari e coerenti con il posizionamento aziendale. |
Oltre alle skill tecniche, emergono con forza le competenze trasversali: gestione dello stress, capacità di lavorare in team distribuiti, comunicazione efficace verso interlocutori non tecnici, sensibilità nel trattare dati potenzialmente sensibili.
### I vantaggi di un CSIRT gestito per la business continuity
Una volta chiarita la struttura del team, il passo successivo è valutare **come garantirne operatività costante, copertura oraria adeguata e accesso a competenze avanzate**. Per molte organizzazioni, la risposta passa attraverso un **CSIRT gestito**, spesso **in modalità ibrida insieme a risorse interne**.
La collaborazione con un partner specializzato consente innanzitutto di **assicurare una copertura effettiva 24/7**, difficilmente sostenibile con un organico interno limitato. Significa avere qualcuno che prende in carico un incidente anche durante la notte, nei weekend o in periodi di picco produttivo, riducendo il tempo in cui un attacco può progredire indisturbato.
In secondo luogo, permette di **accedere a competenze specialistiche** – forensics avanzata, analisi di incidenti OT, gestione di casi complessi in cloud – difficili da reperire e mantenere in azienda in modo continuativo.
### CSIRT, CERT e SOC: differenze chiave e sinergie operative
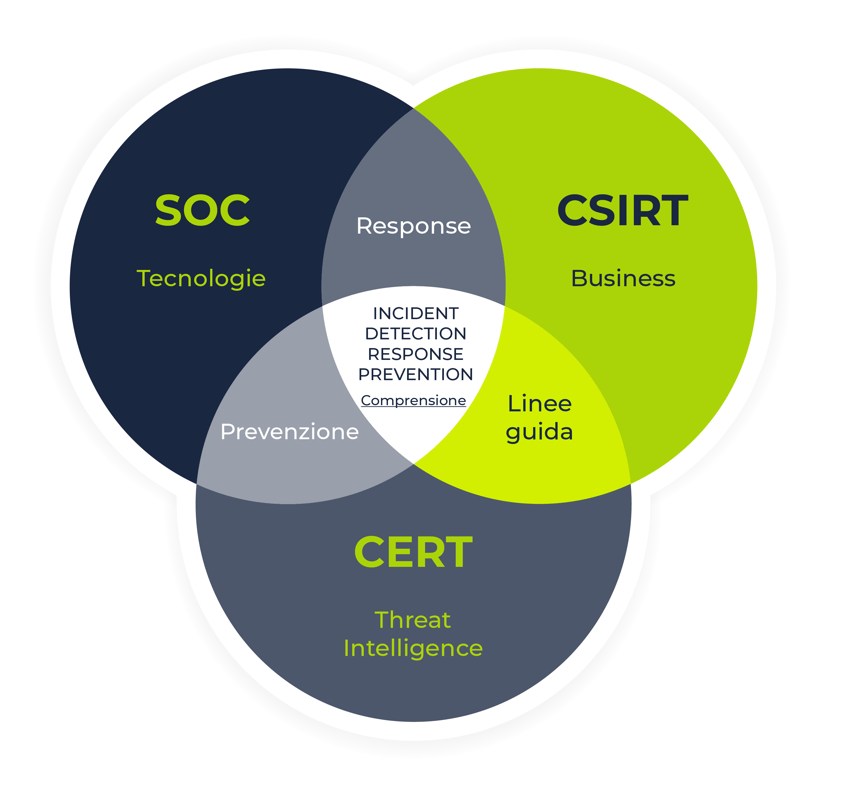
A questo punto, può essere utile distinguere e mettere in relazione le **diverse strutture che intervengono nella gestione degli incidenti**. I tre acronimi più ricorrenti – CSIRT, CERT e SOC – indicano funzioni complementari, che devono essere orchestrate in modo coerente.
- Il **CSIRT** è il team che, all’interno di una singola organizzazione o di un gruppo, **ha il mandato specifico di gestire la risposta agli incidenti**: decide se un evento è effettivamente un incidente, qualifica la gravità, avvia i playbook di contenimento e recovery, coordina la comunicazione verso l’interno e l’esterno.
- Il **CERT** (Computer Emergency Response Team), in molti contesti nazionali o settoriali, svolge invece **un ruolo di coordinamento più ampio**: raccoglie segnalazioni, diffonde alert, emette raccomandazioni e, nei casi più gravi, facilita la gestione di incidenti che coinvolgono più organizzazioni o infrastrutture critiche.
- Il **SOC** (Security Operations Center) **è il centro di monitoraggio continuo** che, tramite SIEM, EDR, NDR e altri strumenti, raccoglie log, rileva anomalie, applica regole di detection e alimenta la pipeline di Incident Response con eventi già arricchiti.
La relazione tipica tra queste funzioni segue un flusso chiaro: **il SOC rileva e classifica gli eventi, il CSIRT valuta e coordina la risposta, il CERT nazionale o settoriale entra in gioco quando l’incidente ha impatti sistemici o richiede cooperazione a livello di paese o industria**.
[](https://blog.quanture.com/hubfs/Rich%20Media/Incident%20response/Incident%20Response_dalla%20detection%20all%E2%80%99azione%2c%20come%20reagire%20in%20tempo_Grafico%202.png)
## Incident response, gli step chiave
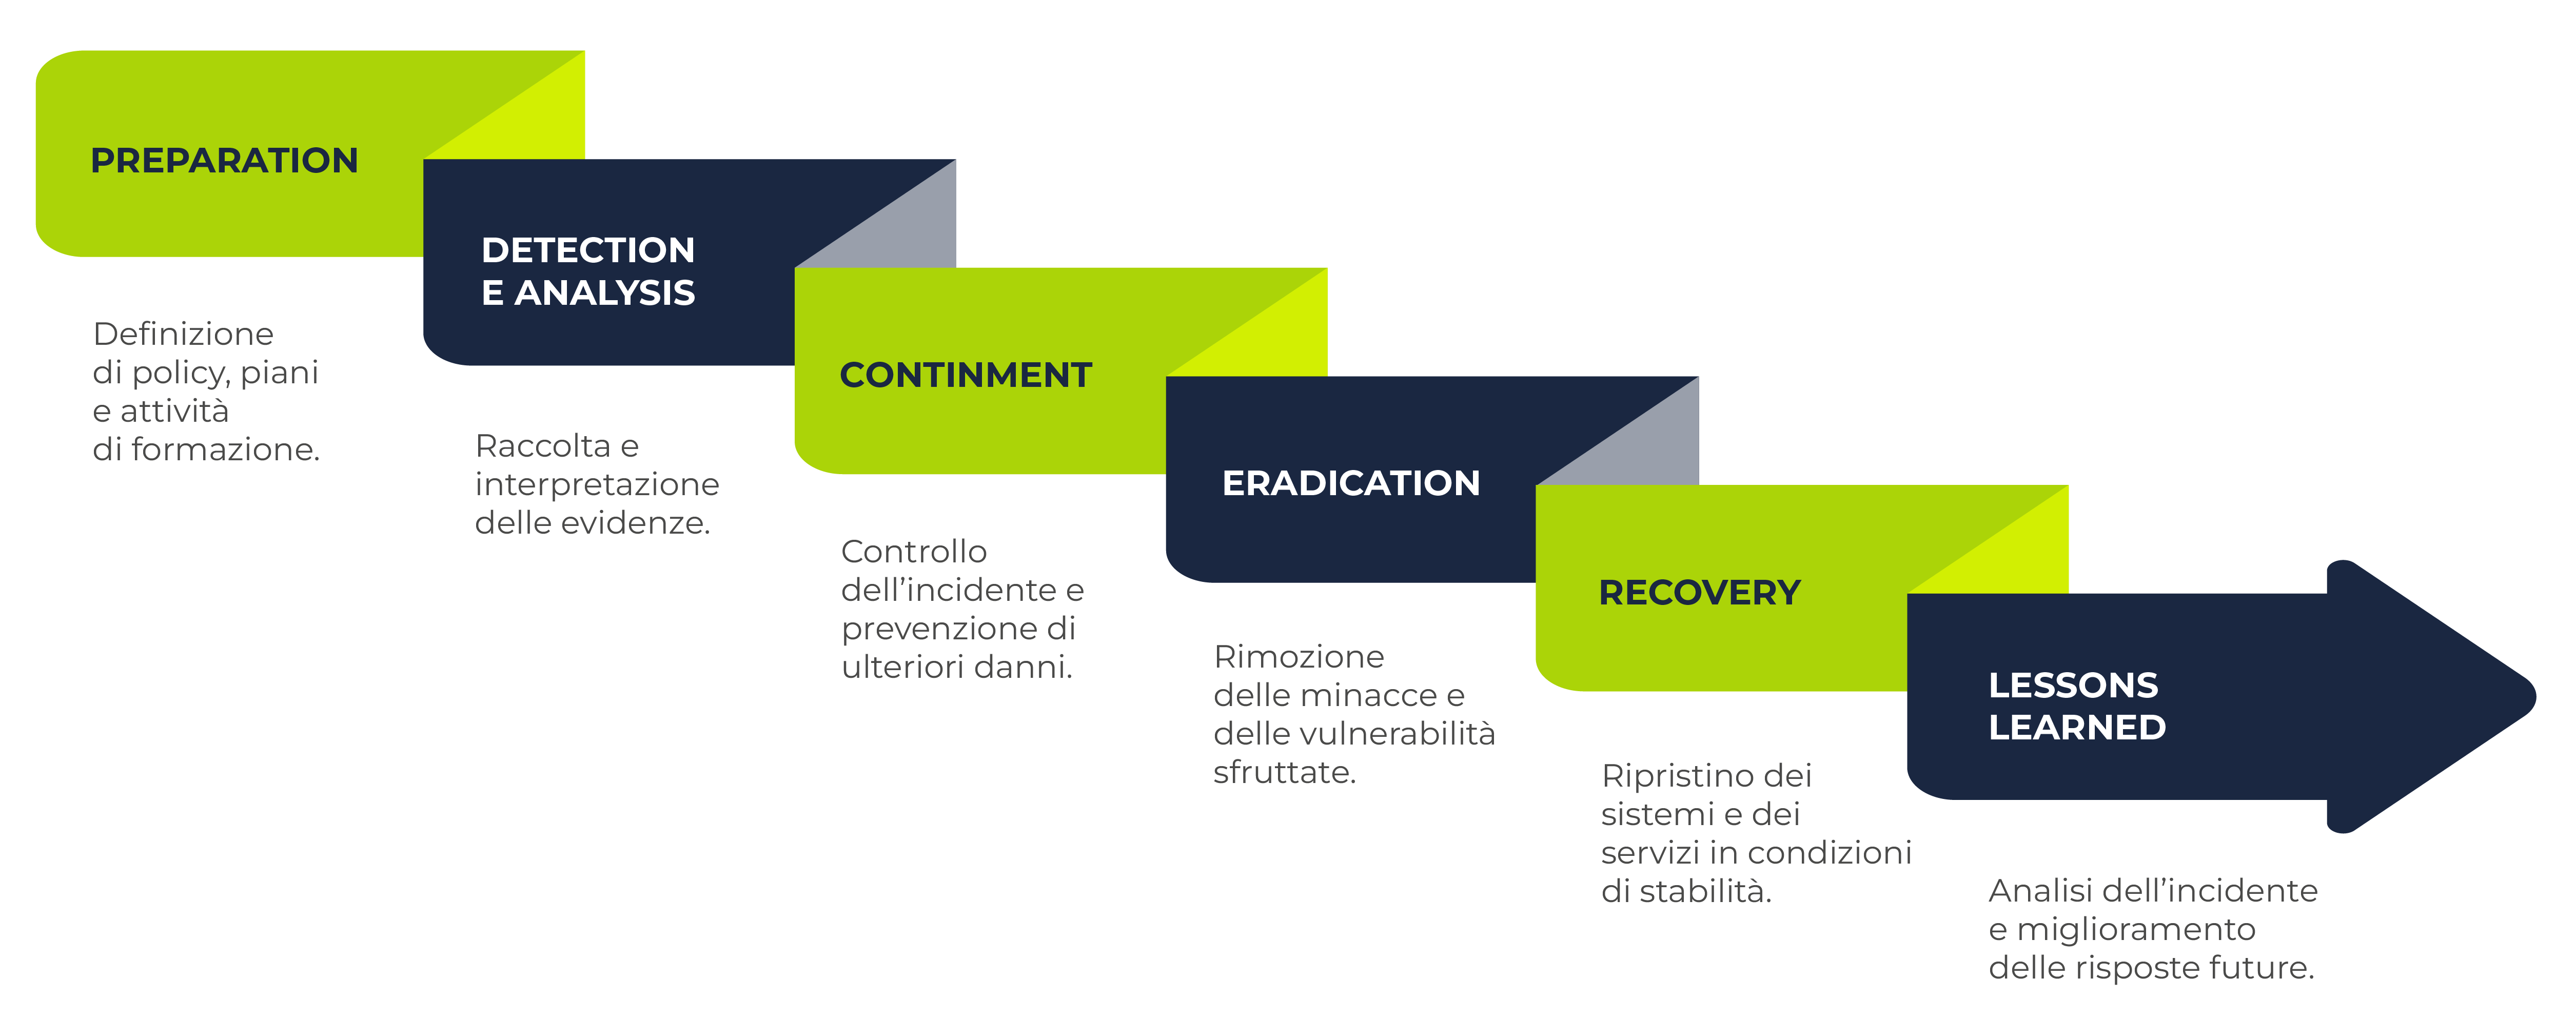
Pur con varianti terminologiche, è possibile individuare le fasi chiave nella gestione della risposta a un incidente di sicurezza. Vediamole nel dettaglio.
### 1. Preparazione
È la fase spesso meno visibile, ma **determinante per tutte le altre**. Comprende la definizione del piano (Incidente Response Plan), la costituzione del team dedicato alla gestione degli incidenti, la predisposizione del logging su sistemi critici, cloud e applicazioni, la configurazione di SIEM, EDR e strumenti di monitoring, la definizione di runbook tecnici e playbook decisionali, la formazione del personale e le esercitazioni periodiche, incluse le simulazioni di tabletop exercise. È in questa fase che si stabiliscono le **metriche di riferimento** rispetto alle quali misurare i progressi.
#### Metriche chiave della Incident Response
| **Metrica** | **Cosa misura** | **Perché è importante** |
| --- | --- | --- |
| **MTTD** **(Mean Time to Detect)** | Il tempo medio necessario per individuare un incidente di sicurezza. | Più è basso, più l’organizzazione è in grado di intercettare rapidamente eventi anomali, riducendone l’impatto. |
| **MTTR** **(Mean Time to Respond / Recover)** | Il tempo medio richiesto per contenere l’incidente e ripristinare sistemi e servizi. | Indica la capacità di tornare operativi rapidamente, limitando fermo e perdite di business. |
| **Tempo di contenimento** | L’intervallo tra l’identificazione dell’incidente e il blocco della sua propagazione. | È cruciale per prevenire l’estensione dell’incidente a dati, sistemi e filiere. |
| **Numero di incidenti gravi** | Il totale degli incidenti ad alto impatto registrati in un periodo definito. | Aiuta a valutare l’esposizione complessiva al rischio e l’efficacia delle misure preventive. |
| **Incidenti rilevati internamente** | La percentuale di incidenti scoperti tramite sistemi e processi interni. | Riflette il livello di maturità della detection rispetto a segnalazioni esterne. |
| **Conformità agli SLA di risposta** | Il rispetto dei tempi di intervento definiti nei piani di Incident Response. | Misura l’affidabilità e la disciplina operativa del processo di risposta agli incidenti. |
### 2. Detection e analisi
In questa fase, l’attenzione si sposta dalla semplice osservazione dei segnali alla **qualificazione dell’evento come incidente di sicurezza**. Le informazioni arrivano da più fonti: alert generati dal SOC, segnalazioni degli utenti, feed di threat intelligence, comunicazioni dei CERT nazionali o settoriali e risultati di attività di threat hunting.
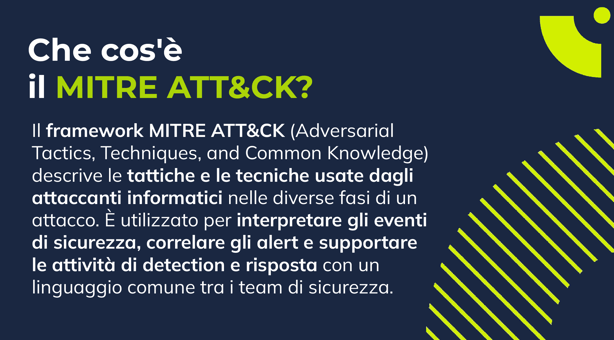
In pratica, il team valuta rapidamente **se un evento supera la soglia di gravità per essere classificato come incidente**, quali asset e quali dati coinvolge, qual è la probabile porta di ingresso (vulnerabilità, credenziali, social engineering), se sono in corso movimenti laterali o esfiltrazioni. I riferimenti al **framework MITRE ATT&CK** permettono di identificare quali tecniche siano state probabilmente utilizzate, di correlare eventi apparentemente isolati e di anticipare possibili step successivi dell’attaccante.
### 3. Contenimento
Una volta identificato l’incidente, **la priorità diventa limitarne l’estensione**. Le opzioni vanno dall’isolamento mirato di host o segmenti di rete alla revoca o sospensione di account compromessi, dalla disconnessione temporanea di sistemi esposti alla limitazione di determinati flussi applicativi. In ambienti industriali, il containment può richiedere anche la segmentazione di linee produttive o l’interruzione controllata di alcune fasi, bilanciando sicurezza e continuità.
**I playbook più efficaci prevedono scenari di contenimento graduati**, che permettono all’incident commander di scegliere misure proporzionate alla gravità senza bloccare in modo indiscriminato l’operatività.
### 4. Eradication
In questa fase si lavora per rimuovere la causa all’origine dell’incidente: eliminazione di malware, chiusura delle vulnerabilità sfruttate, rimozione di backdoor, correzione di configurazioni errate, revisione delle policy di accesso. Qui il collegamento con processi come vulnerability management e gestione delle configurazioni diventa esplicito: un incidente nato da una vulnerabilità non sanata rappresenta un chiaro indicatore della necessità di rafforzare processi di mappatura, remediation e verifica.
### 5. Recovery
Una volta rimossa la causa, l’attenzione si sposta sul **ripristino dei sistemi e dei servizi**. A seconda della gravità, il recovery può consistere nel semplice riavvio di un servizio con monitoraggio rafforzato, nel restore di dati da [backup](https://blog.quanture.com/backup-aziendale-come-funziona-quanto-vale) verificati o nell’attivazione di scenari di [disaster recovery](https://blog.quanture.com/disaster-recovery-plan-perch%C3%A9-e-come-scegliere-il-cloud) con spostamento temporaneo della produzione su infrastrutture alternative.
In questa fase è fondamentale **verificare l’integrità dei sistemi ripristinati e assicurarsi che non siano presenti residui dell’attacco**, bilanciando la rapidità di ripartenza con la necessità di evitare nuove compromissioni.
### 6. Post-incident, lessons learned e miglioramento continuo
Al termine della gestione operativa, il team conduce una revisione strutturata dell’incidente. Viene prodotto un report che **ricostruisce la cronologia dell’evento, analizza le cause e i fattori che ne hanno favorito l’evoluzione, valuta l’efficacia delle misure adottate e formula raccomandazioni** per ridurre il rischio di incidenti analoghi in futuro.
Le lessons learned vengono quindi tradotte in azioni concrete: aggiornamento di policy e procedure, revisione di configurazioni e controlli, introduzione o potenziamento di strumenti, affinamento dei playbook e aggiornamento delle metriche e delle soglie di allarme.
#### Le fasi del processo di gestione degli incidenti
[](https://blog.quanture.com/hubfs/Rich%20Media/Incident%20response/Incident%20Response_dalla%20detection%20all%E2%80%99azione%2c%20come%20reagire%20in%20tempo_Grafico%203.png)
## Incident reponse plan: struttura e principi fondamentali
Definire ruoli e competenze non è sufficiente se la capacità di Incident Response non viene tradotta in un **documento operativo chiaro, condiviso e costantemente aggiornato**: il **piano di risposta agli incidenti (IRP)**. Senza un piano, anche il miglior team rischia di muoversi in modo disordinato; con un piano troppo teorico o non testato, la risposta rischia di non reggere alla prova dei fatti.
L’Incident Response Plan formalizza **come l’organizzazione si prepara, rileva, gestisce e supera un incidente di sicurezza**, fornendo un riferimento unico per decisioni, ruoli e modalità operative. È lo strumento che consente di trasformare principi e best practice in azioni concrete, soprattutto nei momenti in cui tempo e informazioni sono limitati.
Una **struttura tipica** di piano include alcune sezioni ricorrenti:
- un’**introduzione** con scopo, perimetro e definizioni;
- una **tassonomia degli incidenti** e dei livelli di gravità;
- la descrizione dettagliata di **ruoli, responsabilità e meccanismi di escalation**;
- le **procedure di comunicazione** interna ed esterna, con particolare attenzione agli obblighi di notifica previsti da NIS2, DORA e GDPR;
- l’elenco degli **strumenti** e delle **piattaforme di supporto** (SIEM, EDR, strumenti di forensics, soluzioni di backup e disaster recovery);
- i **playbook specifici** per categorie di incidente ad alta probabilità o impatto (ransomware, compromissione di account privilegiati, data breach, incidenti OT);
- le modalità di **test, revisione periodica e formazione**.
Affinché il piano sia realmente efficace, deve rispettare alcuni principi fondamentali. Le procedure devono essere **chiare e concrete**, con passaggi operativi espliciti e riferimenti a sistemi e responsabilità reali. Il piano deve essere **allineato alle priorità di business**, integrandosi con i piani di [business continuity](https://quanture.com/it-solutions/business-continuity/) e [disaster recovery](https://blog.quanture.com/distasterrecoveryasaservice). Deve inoltre essere **proporzionato al rischio**, evitando sia soluzioni eccessivamente complesse sia sottovalutazioni in contesti critici. Infine, l’Incident Response Plan deve essere concepito come un documento **dinamico**, aggiornato sulla base di incidenti reali, esercitazioni e cambiamenti tecnologici.
## Gestione degli incidenti di cyber security in ambienti complessi. Cloud, ibrido, OT/IT, supply chain
Le fasi operative sopracitate assumono caratteristiche diverse quando vengono applicate a contesti tecnologici complessi, distribuiti tra [data center](https://quanture.com/it-solutions/data-center-networking/) tradizionali, cloud pubblici, [ambienti ibridi](https://quanture.com/it-infrastructure/hybrid-infrastructure/) e sistemi OT. In questi scenari, l’Incident Response **deve tenere conto non solo della varietà tecnologica, ma anche delle dipendenze organizzative e regolamentari** che caratterizzano supply chain estese e modelli di erogazione dei servizi sempre più interconnessi.
Negli ambienti **cloud e ibridi**, la principale sfida è la visibilità. I workload possono spostarsi rapidamente tra on‑premise e cloud pubblici, le identità assumono un ruolo centrale per l’accesso a dati e servizi, i log sono distribuiti tra più piattaforme. L’Incident Response deve quindi prevedere playbook specifici per incidenti legati a credenziali e token, chiavi di accesso a servizi cloud, compromissione di container o di pipeline DevOps. La raccolta centralizzata di log e telemetry, l’uso di strumenti nativi di detection e protezione dei workload cloud e l’integrazione con un SOC diventano prerequisiti per una risposta efficace.
Nei contesti **OT/IT convergenti**, il tema si complica ulteriormente. I sistemi di controllo industriale, spesso basati su tecnologie legacy e con finestre di manutenzione ridotte, non possono essere gestiti con le stesse logiche degli endpoint IT. In caso di incidente, le priorità di sicurezza si intrecciano con requisiti di safety e continuità di processo: a volte è preferibile arrestare temporaneamente una linea produttiva piuttosto che rischiare danni fisici a persone o impianti. I playbook di Incident Response devono quindi coinvolgere esplicitamente responsabili di stabilimento, manutenzione e HSE, prevedendo scenari di segmentazione di rete industriale, isolamento di sottosistemi e piani di ripartenza che tengano conto dei vincoli produttivi.
Gli incidenti che coinvolgono la **supply chain** rappresentano un altro fronte critico. In questi casi, l’Incident Response non può limitarsi ai confini dell’organizzazione: deve includere clausole contrattuali che definiscano tempi e modalità di notifica, procedure di coordinamento con i fornitori e scenari di isolamento selettivo di servizi o integrazioni compromesse.
La direttiva NIS2 pone un'enfasi senza precedenti sulla sicurezza della supply chain, richiedendo ai soggetti essenziali e importanti di mappare e gestire attivamente i rischi derivanti dai propri fornitori diretti. Questo obbligo trasforma la gestione della sicurezza dei fornitori da buona pratica a requisito di conformità, imponendo una due diligence rigorosa e la definizione di requisiti di sicurezza contrattuali specifici per l'intera catena del valore.
## Quanture: progettare l'Incident Response per ridurre impatti e tempi di ripristino
In uno scenario in cui il rischio di incidenti di cyber security è elevato, la resilienza dipende dalla capacità di prepararsi prima, non solo di reagire dopo. **Quanture affianca le organizzazioni nella costruzione di capability di Incident Response governate e verificabili**, lavorando su più livelli: definizione di piani e playbook operativi, integrazione tra SOC, CSIRT e funzioni IT, progettazione di infrastrutture resilienti con backup e disaster recovery, e allineamento dei processi di risposta ai requisiti di continuità operativa e compliance normativa.
L’esperienza maturata in contesti complessi consente a Quanture di trasformare la gestione degli incidenti a fattore strutturale di affidabilità del business, riducendo i tempi di rilevazione e ripristino e rendendo la sicurezza un elemento integrato nella progettazione stessa dei servizi digitali.
Condividilo su: [](http://www.facebook.com/share.php?u=https%3A%2F%2Fblog.quanture.com%2Fincident-response-dalla-detection-allazione-come-reagire-in-tempo%3Futm_medium%3Dsocial%26utm_source%3Dfacebook) [](https://twitter.com/intent/tweet?original_referer=https%3A%2F%2Fblog.quanture.com%2Fincident-response-dalla-detection-allazione-come-reagire-in-tempo%3Futm_medium%3Dsocial%26utm_source%3Dtwitter&url=https%3A%2F%2Fblog.quanture.com%2Fincident-response-dalla-detection-allazione-come-reagire-in-tempo%3Futm_medium%3Dsocial%26utm_source%3Dtwitter&source=tweetbutton&text=) [](http://www.linkedin.com/shareArticle?mini=true&url=https%3A%2F%2Fblog.quanture.com%2Fincident-response-dalla-detection-allazione-come-reagire-in-tempo%3Futm_medium%3Dsocial%26utm_source%3Dlinkedin) [](mailto:?subject=Consulta%20https%3A%2F%2Fblog.quanture.com%2Fincident-response-dalla-detection-allazione-come-reagire-in-tempo%3Futm_medium%3Dsocial%26utm_source%3Demail%20&body=Consulta%20https%3A%2F%2Fblog.quanture.com%2Fincident-response-dalla-detection-allazione-come-reagire-in-tempo%3Futm_medium%3Dsocial%26utm_source%3Demail)
Topic: [Cyber Security](https://blog.quanture.com/tag/cyber-security)
## Post Correlati
[Security awareness: trasformare le persone nella prima linea di difesa](https://blog.quanture.com/cybersecurity-awareness)
21 ottobre 2026
[Passwordless authentication: benefici, prerequisiti e rischi da valutare prima dell’adozione](https://blog.quanture.com/passwordless-authentication-benefici-prerequisiti-e-rischi)
19 ottobre 2026
[Direttiva NIS2: obblighi, scadenze e come adeguare la tua azienda](https://blog.quanture.com/cose-la-direttiva-nis2-e-quali-obblighi-di-cybersecurity-richiede)
14 ottobre 2026
## Iscriviti alla Newsletter
## Post più letti
##### [Crisi della RAM: perché i prezzi stanno esplodendo](https://blog.quanture.com/crisi-della-ram)
[News](https://blog.quanture.com/tag/news) - 17/02/2026
##### [Copilot use case: 7 esempi per aumentare la produttività aziendale](https://blog.quanture.com/copilot-use-case-per-aumentare-la-produttivit%C3%A0)
[Microsoft,](https://blog.quanture.com/tag/microsoft) [Intelligenza Artificiale,](https://blog.quanture.com/tag/intelligenza-artificiale) [Quanture.AI](https://blog.quanture.com/tag/quanture-ai) - 09/09/2026
##### [Patch Management, da anello debole a leva per sicurezza e compliance](https://blog.quanture.com/patch-management-da-anello-debole-a-leva-per-sicurezza-e-compliance)
[Cyber Security,](https://blog.quanture.com/tag/cyber-security) [Compliance](https://blog.quanture.com/tag/compliance) - 05/11/2025
## TOPIC
[Cyber Security (65)](https://blog.quanture.com/tag/cyber-security) [Quanture (43)](https://blog.quanture.com/tag/quanture) [Servizi Informatici (36)](https://blog.quanture.com/tag/servizi-informatici) [Cloud (33)](https://blog.quanture.com/tag/cloud) [Microsoft (31)](https://blog.quanture.com/tag/microsoft) [HPE (30)](https://blog.quanture.com/tag/hpe) [Data Storage (29)](https://blog.quanture.com/tag/data-storage) [Business Continuity (28)](https://blog.quanture.com/tag/business-continuity) [Collaboration (24)](https://blog.quanture.com/tag/collaboration) [Microsoft365 (23)](https://blog.quanture.com/tag/microsoft365) [Disaster Recovery (20)](https://blog.quanture.com/tag/disaster-recovery) [Imagine a NEW PLAN (20)](https://blog.quanture.com/tag/imagine-a-new-plan) [Intelligenza Artificiale (17)](https://blog.quanture.com/tag/intelligenza-artificiale) [Virtualizzazione (17)](https://blog.quanture.com/tag/virtualizzazione) [Sustainability (14)](https://blog.quanture.com/tag/sustainability) [Consulting Service (12)](https://blog.quanture.com/tag/consulting-service) [Iperconvergenza (12)](https://blog.quanture.com/tag/iperconvergenza) [Managed Service (10)](https://blog.quanture.com/tag/managed-service) [Compliance (9)](https://blog.quanture.com/tag/compliance) [Quanture.AI (9)](https://blog.quanture.com/tag/quanture-ai) [Ransomware (9)](https://blog.quanture.com/tag/ransomware) [Smart Working aziendale (9)](https://blog.quanture.com/tag/smart-working-aziendale) [Backup aziendale (8)](https://blog.quanture.com/tag/backup-aziendale) [Data Governance (8)](https://blog.quanture.com/tag/data-governance) [Citrix (7)](https://blog.quanture.com/tag/citrix) [Communication (5)](https://blog.quanture.com/tag/communication) [Ethical hacking (5)](https://blog.quanture.com/tag/ethical-hacking) [GDPR (4)](https://blog.quanture.com/tag/gdpr) [HP (4)](https://blog.quanture.com/tag/hp) [Azure Virtual Desktop (3)](https://blog.quanture.com/tag/azure-virtual-desktop) [News (3)](https://blog.quanture.com/tag/news) [Windows 365 (3)](https://blog.quanture.com/tag/windows-365) [Digital Identity (2)](https://blog.quanture.com/tag/digital-identity) [Windows Virtual Desktop (2)](https://blog.quanture.com/tag/windows-virtual-desktop) [CSP (1)](https://blog.quanture.com/tag/csp) [Infrastruttura IT (1)](https://blog.quanture.com/tag/infrastruttura-it) [OpenLicense (1)](https://blog.quanture.com/tag/openlicense) [RPO (1)](https://blog.quanture.com/tag/rpo) [VMware (1)](https://blog.quanture.com/tag/vmware) [Windows11 (1)](https://blog.quanture.com/tag/windows11)

**QUANTURE HQ**
Via delle Radici, 309-315
41043 Formigine (Modena)
Ph. +39 059 557530
**[info@quanture.com](mailto:info@quanture.com)**
Contacts Newsletter
/ AREAS
[IT Design & Engineering](https://www.quanture.com/it-infrastructure/) [Smart Productivity](https://www.quanture.com/smart-productivity/) [Cyber security](https://www.quanture.com/cyber-security/) [Microsoft Advisory Services](https://www.quanture.com/microsoft-advisory-services/) [Dev & Apps](https://www.quanture.com/development/)
/ ABOUT
[We are](https://www.quanture.com/we-are/) [We care](https://www.quanture.com/we-care/) [Join us](https://www.quanture.com/join-us/) [Success stories](https://www.quanture.com/case-studies/) [DOT](https://blog.quanture.com/) [My.Quanture](https://www.quanture.com/myquanture/)
/ TOPIC

[Cyber security](https://blog.quanture.com/tag/cyber-security), [Microsoft](https://blog.quanture.com/tag/microsoft), [Cloud](https://blog.quanture.com/tag/cloud), [Data Storage](https://blog.quanture.com/tag/data-storage), [Business Continuity](https://blog.quanture.com/tag/business-continuity), [HPE](https://blog.quanture.com/tag/hpe), [Servizi Informatici](https://blog.quanture.com/tag/servizi-informatici), [Collaboration](https://blog.quanture.com/tag/collaboration), [Disaster Recovery](https://blog.quanture.com/tag/disaster-recovery), [Virtualizzazione](https://blog.quanture.com/tag/virtualizzazione), [Quanture](https://blog.quanture.com/tag/quanture),
[Iperconvergenza](https://blog.quanture.com/tag/iperconvergenza), [Ransomware](https://blog.quanture.com/tag/ransomware), [Smart Working aziendale](https://blog.quanture.com/tag/smart-working-aziendale), [Citrix](https://blog.quanture.com/tag/citrix), [Backup aziendale](https://blog.quanture.com/tag/backup-aziendale), [Ethical hacking](https://blog.quanture.com/tag/ethical-hacking), [HP](https://blog.quanture.com/tag/hp), [GDPR](https://blog.quanture.com/tag/gdpr), [Microsoft365](https://blog.quanture.com/tag/microsoft365), [Windows 365](https://blog.quanture.com/tag/windows-365), [Azure Virtual Desktop,](https://blog.quanture.com/tag/azure-virtual-desktop) [Sustainability](https://blog.quanture.com/tag/sustainability), [Windows Virtual Desktop](https://blog.quanture.com/tag/windows-virtual-desktop), [CSP](https://blog.quanture.com/tag/csp), [OpenLicense](https://blog.quanture.com/tag/openlicense), [VMware](https://blog.quanture.com/tag/vmware), [Windows11](https://blog.quanture.com/tag/windows11)

Quanture è azienda certificata UNI EN ISO 9001:2015 n° 50 100 13264 Rev.005
© QUANTURE P. IVA 03317290363 | [PRIVACY POLICY](https://quanture.com/privacy-policy-quanture/) – [COOKIE POLICY](https://www.iubenda.com/privacy-policy/84662247/cookie-policy) - [WHISTLEBLOWING](https://quanture.com/whistleblowing-quanture/)
```json
{
"@context" : "https://schema.org",
"@type" : "BlogPosting",
"author" : {
"@type" : "Person",
"name" : "quanture_social",
"url" : "https://blog.quanture.com/author/quanture"
},
"dateModified" : "2026-10-26T16:26:30.663Z",
"datePublished" : "2026-01-20T08:00:00.000Z",
"headline" : "Incident Response: dalla detection all’azione, come reagire in tempo",
"image" : [ "https://blog.quanture.com/hubfs/124.png" ],
"mainEntityOfPage" : {
"@id" : "https://blog.quanture.com/incident-response-dalla-detection-allazione-come-reagire-in-tempo",
"@type" : "WebPage"
},
"publisher" : {
"@type" : "Organization",
"logo" : {
"@type" : "ImageObject",
"url" : "https://blog.quanture.com/hubfs/QUANTURE_LOGO_PAYOFF_POSITIVO_PRIMARIO-1.png"
},
"name" : "Quanture S.p.A."
}
}
```
```json
{
"@context" : "https://schema.org",
"@type" : "Article",
"about" : {
"@type" : "Thing",
"name" : "Cyber Security"
},
"articleBody" : "Il quadro delineato dal Rapporto Clusit sulla Cybersecurity in Italia evidenzia come gli incidenti di sicurezza informatica rappresentino ormai una condizione strutturale di rischio per organizzazioni pubbliche e private. La crescita costante del numero di incidenti gravi, unita all’aumento della loro complessità e dell’impatto operativo, sta mettendo sotto pressione la continuità dei servizi e la capacità di risposta delle aziende. In particolare, il report sottolinea come una quota rilevante degli incidenti abbia effetti diretti sulla disponibilità dei sistemi, sull’integrità dei dati e sull’operatività delle filiere digitali, ampliando l’impatto ben oltre il perimetro tecnologico. Incidenti cyber, i numeri chiave Fonte: Rapporto Clusit – Aggiornamento ottobre 2025. Perché oggi l’Incident Response è una priorità di business Alla luce di una crescita così marcata degli incidenti, risulta evidente come la capacità di rilevare tempestivamente gli eventi, contenerne gli effetti e ripristinare i servizi critici si colloca al crocevia tra gestione del rischio, continuità del business e responsabilità diretta del top management, diventando una leva strategica per la tutela del valore aziendale. L’entrata in vigore della direttiva NIS2 e del regolamento DORA, insieme agli obblighi di notifica e accountability previsti dal GDPR, infatti, ha spostato in modo esplicito la responsabilità della gestione del rischio cyber sui vertici aziendali. L’Incident Response rientra a pieno titolo nelle responsabilità di governance, con effetti diretti sulle decisioni strategiche e potenziali conseguenze per l’organizzazione e i suoi organi di amministrazione in caso di processi inadeguati, sia sul piano sanzionatorio sia su quello reputazionale. I report di settore e le indicazioni normative convergono quindi su un punto chiave: la domanda non è più se un’organizzazione subirà un incidente di sicurezza, ma quanto rapidamente e con quale coordinamento sarà in grado di gestirlo. È quindi anche su questa capacità che si misura oggi la resilienza digitale e, di conseguenza, la solidità del business nel medio-lungo periodo. Che cos’è l’Incident Response e quali obiettivi si pone Secondo il NIST (National Institute of Standards and Technology), uno dei riferimenti più autorevoli in materia, l’Incident Response è l’insieme coordinato di processi, ruoli e strumenti attraverso cui un’organizzazione si prepara, rileva, analizza, contiene e assorbe gli effetti di un incidente di cyber security, integrando queste attività nel più ampio ciclo di gestione del rischio. Il modello di riferimento distingue tra due livelli strettamente connessi. Da un lato le funzioni di Govern, Identify e Protect, che costituiscono lo strato di preparazione e governo del rischio. Dall’altro le funzioni di Detect, Respond e Recover, che rappresentano il cuore operativo della Incident Response. A collegare questi livelli è un processo di miglioramento continuo, alimentato dall’analisi sistematica degli incidenti e delle lessons learned. Gli obiettivi di una capability di Incident Response efficace sono molteplici, ma riconducibili ad alcune finalità chiave. Innanzitutto, ridurre l’impatto tecnico e di business degli incidenti, limitando indisponibilità dei servizi, compromissioni dei dati e interruzioni operative. In secondo luogo, ripristinare rapidamente i servizi critici, rispettando gli obiettivi di recupero definiti nei piani di continuità. Un terzo obiettivo è contenere la propagazione dell’incidente, evitando che si estenda ad altri sistemi, sedi o attori della supply chain. Infine, ogni incidente deve diventare un’occasione di apprendimento, utile a rafforzare controlli, processi e competenze interne. L’Incident Response non sostituisce altre funzioni di sicurezza, come ad esempio il vulnerability management, ma le integra: un incidente causato da una vulnerabilità non gestita deve tradursi in un miglioramento strutturale delle pratiche di gestione e di configurazione dei sistemi. In questa prospettiva, l’Incident Response non è un insieme di reazioni isolate, ma un processo strutturato e continuo. Incident response team: ruoli, responsabilità e competenze chiave Dato il perimetro di attività così articolato, l’Incident Response non può essere affidato a singoli specialisti isolati o a interventi occasionali. Serve un team strutturato, con ruoli definiti, responsabilità chiare e collaborazione costante con le altre funzioni di sicurezza e IT. Ciò che conta è la capacità del team di orchestrare competenze eterogenee. Una possibile articolazione dei ruoli chiave è la seguente. CSIRT - Computer Security Incident Response Ruolo Responsabilità principali Competenze distintive Incident commander Coordina la risposta, gestisce le priorità, decide sulle azioni critiche di contenimento e recovery, interfaccia il management. Leadership, capacità decisionale in contesti incompleti, gestione della crisi, visione risk‑based. Lead analyst / triage Valuta gli alert, classifica gli eventi, attiva i playbook, coordina gli analisti tecnici. SIEM, EDR, log analysis, conoscenza di MITRE ATT&CK e dei pattern di attacco più diffusi. Forensics specialist Conduce analisi forense su host, rete e supporti, ricostruisce la catena di attacco, raccoglie evidenze. Digital forensics, memory e disk analysis, metodologie di catena di custodia, familiarità con strumenti DFIR. Threat intelligence analyst Arricchisce i casi con informazioni su attori, TTP, indicatori di compromissione, contesto geopolitico e settoriale. Cyber threat intelligence, uso avanzato di MITRE ATT&CK, capacità di sintesi e reporting per stakeholder diversi. SOC / monitoring analyst Gestisce il monitoraggio continuo, affina le regole di rilevazione, filtra falsi positivi, alimenta IR con eventi qualificati. SIEM, SOAR, tuning di use case di detection, conoscenza delle architetture di log in ambienti cloud e ibridi. IT / cloud engineer Implementa le azioni tecniche di isolamento, patching, restore, re‑configurazione di sistemi e servizi. Amministrazione di sistemi on‑premise, competenze su Azure e altri cloud, networking, automazione infrastrutturale. Referente OT / produzione Valuta l’impatto sugli impianti produttivi, coordina le azioni in campo, bilancia sicurezza e continuità operativa. Conoscenza dei sistemi di controllo industriale, processi di stabilimento, requisiti di safety e disponibilità. Legal & compliance Supporta notifiche alle autorità, gestione di data breach, aspetti contrattuali e di responsabilità. Normative come GDPR, NIS2 e DORA, gestione di data breach, linguaggio legale applicato agli incidenti cyber. Comunicazione / PR Gestisce comunicazione interna ed esterna in caso di incidenti gravi, presidia i messaggi verso clienti e media. Comunicazione di crisi, capacità di tradurre aspetti tecnici in messaggi chiari e coerenti con il posizionamento aziendale. Oltre alle skill tecniche, emergono con forza le competenze trasversali: gestione dello stress, capacità di lavorare in team distribuiti, comunicazione efficace verso interlocutori non tecnici, sensibilità nel trattare dati potenzialmente sensibili. I vantaggi di un CSIRT gestito per la business continuity Una volta chiarita la struttura del team, il passo successivo è valutare come garantirne operatività costante, copertura oraria adeguata e accesso a competenze avanzate. Per molte organizzazioni, la risposta passa attraverso un CSIRT gestito, spesso in modalità ibrida insieme a risorse interne. La collaborazione con un partner specializzato consente innanzitutto di assicurare una copertura effettiva 24/7, difficilmente sostenibile con un organico interno limitato. Significa avere qualcuno che prende in carico un incidente anche durante la notte, nei weekend o in periodi di picco produttivo, riducendo il tempo in cui un attacco può progredire indisturbato. In secondo luogo, permette di accedere a competenze specialistiche – forensics avanzata, analisi di incidenti OT, gestione di casi complessi in cloud – difficili da reperire e mantenere in azienda in modo continuativo. CSIRT, CERT e SOC: differenze chiave e sinergie operative A questo punto, può essere utile distinguere e mettere in relazione le diverse strutture che intervengono nella gestione degli incidenti. I tre acronimi più ricorrenti – CSIRT, CERT e SOC – indicano funzioni complementari, che devono essere orchestrate in modo coerente. Il CSIRT è il team che, all’interno di una singola organizzazione o di un gruppo, ha il mandato specifico di gestire la risposta agli incidenti: decide se un evento è effettivamente un incidente, qualifica la gravità, avvia i playbook di contenimento e recovery, coordina la comunicazione verso l’interno e l’esterno. Il CERT (Computer Emergency Response Team), in molti contesti nazionali o settoriali, svolge invece un ruolo di coordinamento più ampio: raccoglie segnalazioni, diffonde alert, emette raccomandazioni e, nei casi più gravi, facilita la gestione di incidenti che coinvolgono più organizzazioni o infrastrutture critiche. Il SOC (Security Operations Center) è il centro di monitoraggio continuo che, tramite SIEM, EDR, NDR e altri strumenti, raccoglie log, rileva anomalie, applica regole di detection e alimenta la pipeline di Incident Response con eventi già arricchiti. La relazione tipica tra queste funzioni segue un flusso chiaro: il SOC rileva e classifica gli eventi, il CSIRT valuta e coordina la risposta, il CERT nazionale o settoriale entra in gioco quando l’incidente ha impatti sistemici o richiede cooperazione a livello di paese o industria. Incident response, gli step chiave Pur con varianti terminologiche, è possibile individuare le fasi chiave nella gestione della risposta a un incidente di sicurezza. Vediamole nel dettaglio. 1. Preparazione È la fase spesso meno visibile, ma determinante per tutte le altre. Comprende la definizione del piano (Incidente Response Plan), la costituzione del team dedicato alla gestione degli incidenti, la predisposizione del logging su sistemi critici, cloud e applicazioni, la configurazione di SIEM, EDR e strumenti di monitoring, la definizione di runbook tecnici e playbook decisionali, la formazione del personale e le esercitazioni periodiche, incluse le simulazioni di tabletop exercise. È in questa fase che si stabiliscono le metriche di riferimento rispetto alle quali misurare i progressi. Metriche chiave della Incident Response Metrica Cosa misura Perché è importante MTTD (Mean Time to Detect) Il tempo medio necessario per individuare un incidente di sicurezza. Più è basso, più l’organizzazione è in grado di intercettare rapidamente eventi anomali, riducendone l’impatto. MTTR (Mean Time to Respond / Recover) Il tempo medio richiesto per contenere l’incidente e ripristinare sistemi e servizi. Indica la capacità di tornare operativi rapidamente, limitando fermo e perdite di business. Tempo di contenimento L’intervallo tra l’identificazione dell’incidente e il blocco della sua propagazione. È cruciale per prevenire l’estensione dell’incidente a dati, sistemi e filiere. Numero di incidenti gravi Il totale degli incidenti ad alto impatto registrati in un periodo definito. Aiuta a valutare l’esposizione complessiva al rischio e l’efficacia delle misure preventive. Incidenti rilevati internamente La percentuale di incidenti scoperti tramite sistemi e processi interni. Riflette il livello di maturità della detection rispetto a segnalazioni esterne. Conformità agli SLA di risposta Il rispetto dei tempi di intervento definiti nei piani di Incident Response. Misura l’affidabilità e la disciplina operativa del processo di risposta agli incidenti. 2. Detection e analisi In questa fase, l’attenzione si sposta dalla semplice osservazione dei segnali alla qualificazione dell’evento come incidente di sicurezza. Le informazioni arrivano da più fonti: alert generati dal SOC, segnalazioni degli utenti, feed di threat intelligence, comunicazioni dei CERT nazionali o settoriali e risultati di attività di threat hunting. In pratica, il team valuta rapidamente se un evento supera la soglia di gravità per essere classificato come incidente, quali asset e quali dati coinvolge, qual è la probabile porta di ingresso (vulnerabilità, credenziali, social engineering), se sono in corso movimenti laterali o esfiltrazioni. I riferimenti al framework MITRE ATT&CK permettono di identificare quali tecniche siano state probabilmente utilizzate, di correlare eventi apparentemente isolati e di anticipare possibili step successivi dell’attaccante. 3. Contenimento Una volta identificato l’incidente, la priorità diventa limitarne l’estensione. Le opzioni vanno dall’isolamento mirato di host o segmenti di rete alla revoca o sospensione di account compromessi, dalla disconnessione temporanea di sistemi esposti alla limitazione di determinati flussi applicativi. In ambienti industriali, il containment può richiedere anche la segmentazione di linee produttive o l’interruzione controllata di alcune fasi, bilanciando sicurezza e continuità. I playbook più efficaci prevedono scenari di contenimento graduati, che permettono all’incident commander di scegliere misure proporzionate alla gravità senza bloccare in modo indiscriminato l’operatività. 4. Eradication In questa fase si lavora per rimuovere la causa all’origine dell’incidente: eliminazione di malware, chiusura delle vulnerabilità sfruttate, rimozione di backdoor, correzione di configurazioni errate, revisione delle policy di accesso. Qui il collegamento con processi come vulnerability management e gestione delle configurazioni diventa esplicito: un incidente nato da una vulnerabilità non sanata rappresenta un chiaro indicatore della necessità di rafforzare processi di mappatura, remediation e verifica. 5. Recovery Una volta rimossa la causa, l’attenzione si sposta sul ripristino dei sistemi e dei servizi. A seconda della gravità, il recovery può consistere nel semplice riavvio di un servizio con monitoraggio rafforzato, nel restore di dati da backup verificati o nell’attivazione di scenari di disaster recovery con spostamento temporaneo della produzione su infrastrutture alternative. In questa fase è fondamentale verificare l’integrità dei sistemi ripristinati e assicurarsi che non siano presenti residui dell’attacco, bilanciando la rapidità di ripartenza con la necessità di evitare nuove compromissioni. 6. Post-incident, lessons learned e miglioramento continuo Al termine della gestione operativa, il team conduce una revisione strutturata dell’incidente. Viene prodotto un report che ricostruisce la cronologia dell’evento, analizza le cause e i fattori che ne hanno favorito l’evoluzione, valuta l’efficacia delle misure adottate e formula raccomandazioni per ridurre il rischio di incidenti analoghi in futuro. Le lessons learned vengono quindi tradotte in azioni concrete: aggiornamento di policy e procedure, revisione di configurazioni e controlli, introduzione o potenziamento di strumenti, affinamento dei playbook e aggiornamento delle metriche e delle soglie di allarme. Le fasi del processo di gestione degli incidenti Incident reponse plan: struttura e principi fondamentali Definire ruoli e competenze non è sufficiente se la capacità di Incident Response non viene tradotta in un documento operativo chiaro, condiviso e costantemente aggiornato: il piano di risposta agli incidenti (IRP). Senza un piano, anche il miglior team rischia di muoversi in modo disordinato; con un piano troppo teorico o non testato, la risposta rischia di non reggere alla prova dei fatti. L’Incident Response Plan formalizza come l’organizzazione si prepara, rileva, gestisce e supera un incidente di sicurezza, fornendo un riferimento unico per decisioni, ruoli e modalità operative. È lo strumento che consente di trasformare principi e best practice in azioni concrete, soprattutto nei momenti in cui tempo e informazioni sono limitati. Una struttura tipica di piano include alcune sezioni ricorrenti: un’introduzione con scopo, perimetro e definizioni; una tassonomia degli incidenti e dei livelli di gravità; la descrizione dettagliata di ruoli, responsabilità e meccanismi di escalation; le procedure di comunicazione interna ed esterna, con particolare attenzione agli obblighi di notifica previsti da NIS2, DORA e GDPR; l’elenco degli strumenti e delle piattaforme di supporto (SIEM, EDR, strumenti di forensics, soluzioni di backup e disaster recovery); i playbook specifici per categorie di incidente ad alta probabilità o impatto (ransomware, compromissione di account privilegiati, data breach, incidenti OT); le modalità di test, revisione periodica e formazione. Affinché il piano sia realmente efficace, deve rispettare alcuni principi fondamentali. Le procedure devono essere chiare e concrete, con passaggi operativi espliciti e riferimenti a sistemi e responsabilità reali. Il piano deve essere allineato alle priorità di business, integrandosi con i piani di business continuity e disaster recovery. Deve inoltre essere proporzionato al rischio, evitando sia soluzioni eccessivamente complesse sia sottovalutazioni in contesti critici. Infine, l’Incident Response Plan deve essere concepito come un documento dinamico, aggiornato sulla base di incidenti reali, esercitazioni e cambiamenti tecnologici. Gestione degli incidenti di cyber security in ambienti complessi. Cloud, ibrido, OT/IT, supply chain Le fasi operative sopracitate assumono caratteristiche diverse quando vengono applicate a contesti tecnologici complessi, distribuiti tra data center tradizionali, cloud pubblici, ambienti ibridi e sistemi OT. In questi scenari, l’Incident Response deve tenere conto non solo della varietà tecnologica, ma anche delle dipendenze organizzative e regolamentari che caratterizzano supply chain estese e modelli di erogazione dei servizi sempre più interconnessi. Negli ambienti cloud e ibridi, la principale sfida è la visibilità. I workload possono spostarsi rapidamente tra on‑premise e cloud pubblici, le identità assumono un ruolo centrale per l’accesso a dati e servizi, i log sono distribuiti tra più piattaforme. L’Incident Response deve quindi prevedere playbook specifici per incidenti legati a credenziali e token, chiavi di accesso a servizi cloud, compromissione di container o di pipeline DevOps. La raccolta centralizzata di log e telemetry, l’uso di strumenti nativi di detection e protezione dei workload cloud e l’integrazione con un SOC diventano prerequisiti per una risposta efficace. Nei contesti OT/IT convergenti, il tema si complica ulteriormente. I sistemi di controllo industriale, spesso basati su tecnologie legacy e con finestre di manutenzione ridotte, non possono essere gestiti con le stesse logiche degli endpoint IT. In caso di incidente, le priorità di sicurezza si intrecciano con requisiti di safety e continuità di processo: a volte è preferibile arrestare temporaneamente una linea produttiva piuttosto che rischiare danni fisici a persone o impianti. I playbook di Incident Response devono quindi coinvolgere esplicitamente responsabili di stabilimento, manutenzione e HSE, prevedendo scenari di segmentazione di rete industriale, isolamento di sottosistemi e piani di ripartenza che tengano conto dei vincoli produttivi. Gli incidenti che coinvolgono la supply chain rappresentano un altro fronte critico. In questi casi, l’Incident Response non può limitarsi ai confini dell’organizzazione: deve includere clausole contrattuali che definiscano tempi e modalità di notifica, procedure di coordinamento con i fornitori e scenari di isolamento selettivo di servizi o integrazioni compromesse. La direttiva NIS2 pone un'enfasi senza precedenti sulla sicurezza della supply chain, richiedendo ai soggetti essenziali e importanti di mappare e gestire attivamente i rischi derivanti dai propri fornitori diretti. Questo obbligo trasforma la gestione della sicurezza dei fornitori da buona pratica a requisito di conformità, imponendo una due diligence rigorosa e la definizione di requisiti di sicurezza contrattuali specifici per l'intera catena del valore. Quanture: progettare l'Incident Response per ridurre impatti e tempi di ripristino In uno scenario in cui il rischio di incidenti di cyber security è elevato, la resilienza dipende dalla capacità di prepararsi prima, non solo di reagire dopo. Quanture affianca le organizzazioni nella costruzione di capability di Incident Response governate e verificabili, lavorando su più livelli: definizione di piani e playbook operativi, integrazione tra SOC, CSIRT e funzioni IT, progettazione di infrastrutture resilienti con backup e disaster recovery, e allineamento dei processi di risposta ai requisiti di continuità operativa e compliance normativa. L’esperienza maturata in contesti complessi consente a Quanture di trasformare la gestione degli incidenti a fattore strutturale di affidabilità del business, riducendo i tempi di rilevazione e ripristino e rendendo la sicurezza un elemento integrato nella progettazione stessa dei servizi digitali.",
"author" : {
"@type" : "Person",
"name" : "quanture_social",
"sameAs" : [ "https://www.linkedin.com/company/quanture-it-consulting/posts/" ],
"url" : "https://blog.quanture.com/author/quanture"
},
"dateModified" : "1793031990671",
"datePublished" : "2026-01-20 08:00:00",
"description" : "Processi, ruoli e piani per gestire gli incidenti di cyber security e proteggere continuità operativa e resilienza del business.",
"editor" : {
"@type" : "Person",
"name" : "quanture_social"
},
"headline" : "Incident Response: dalla detection all’azione, come reagire in tempo",
"image" : {
"@type" : "ImageObject",
"height" : 675,
"url" : "https://content.quanture.com/hubfs/124.png",
"width" : 1200
},
"inLanguage" : "it-IT",
"isAccessibleForFree" : true,
"mainEntityOfPage" : {
"@id" : "https://blog.quanture.com/incident-response-dalla-detection-allazione-come-reagire-in-tempo",
"@type" : "WebPage"
},
"publisher" : {
"@type" : "Organization",
"logo" : {
"@type" : "ImageObject",
"url" : "https://content.quanture.com/hubfs/QUANTURE_LOGO_PAYOFF_POSITIVO_PRIMARIO-1.png"
},
"name" : "Il Blog",
"sameAs" : [ "https://www.linkedin.com/company/quanture-it-consulting/posts/" ]
},
"url" : "https://blog.quanture.com/incident-response-dalla-detection-allazione-come-reagire-in-tempo",
"wordCount" : 3027
}
```